इस लिस्टिंग के बारे में
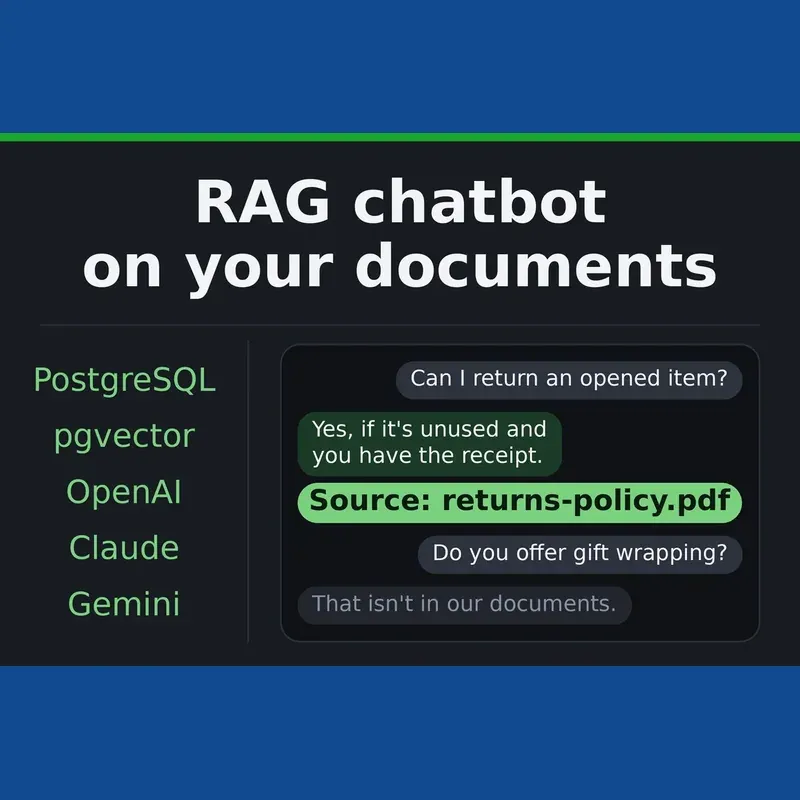
आपके महत्वपूर्ण उत्तर आपके मैनुअल, नीतियों, मूल्य सूचियों, सहायता संबंधी लेखों और अनुबंधों में पहले से ही सहेजे गए हैं। हम एक ऐसा चैटबॉट बनाते हैं जो इन दस्तावेज़ों का विश्लेषण करता है और केवल उन्हीं आंकड़ों का उपयोग करके उत्तर देता है जो उसे इनमें मिलते हैं, साथ ही प्रत्येक प्रतिक्रिया के लिए सटीक फ़ाइल और पृष्ठ या अनुभाग का संदर्भ प्रदान करता है। जब आपकी फ़ाइलों में कोई उत्तर उपलब्ध नहीं होता है, तो सहायक अनुमान लगाने के बजाय इसे स्पष्ट रूप से बता देता है।
प्रत्येक प्रोजेक्ट आपके स्वयं के अधिकतम 20 प्रश्नों का उपयोग करके सत्यापन परीक्षण के साथ समाप्त होता है। आपको प्रत्येक उत्तर, उसके स्रोत और उसकी सटीकता रेटिंग को सूचीबद्ध करने वाली एक विस्तृत स्प्रेडशीट मिलती है, जिसके बाद एक संशोधन चक्र और एक पूर्ण पुन: परीक्षण होता है। आप स्रोत कोड का पूर्ण स्वामित्व बनाए रखते हैं, और चूंकि बॉट आपके चयनित AI प्रदाता के साथ आपके व्यक्तिगत खाते पर चलता है, इसलिए उपयोग के सभी बिल सीधे आपको भेजे जाते हैं और हमारी ओर से कोई आवर्ती शुल्क नहीं लिया जाता है।
दस्तावेज़ खोज बॉट के साथ जुड़े एक कॉम्पैक्ट मॉडल के माध्यम से चलती है, जबकि अनुक्रमणिका pgvector का उपयोग करके PostgreSQL में रखी जाती है। यह आपकी फ़ाइलों को AI प्रदाता से दूर रखता है और किसी भी Postgres या Supabase इंस्टॉलेशन पर बाहरी वेक्टर डेटाबेस की आवश्यकता को समाप्त करता है। हाल के काम में एक चुनाव ट्रेडिंग डेस्क पर लाइव Supabase बैकएंड के लिए वेक्टर खोज प्रणाली विकसित करना शामिल है, जिसमें फ़िल्टर की गई समानता खोज, टीम-आधारित पहुंच प्रतिबंध और सहेजने से पहले स्वीकृत भाषा मॉडल द्वारा उत्पन्न प्रति घंटा सारांश शामिल थे।
हम सहमत विनिर्देशों के विरुद्ध किसी भी विसंगति को बिना किसी अतिरिक्त शुल्क के ठीक करने के लिए डिलीवरी के बाद 14 दिनों की सहायता प्रदान करते हैं।
किसी वीडियो या फ़ोन कॉल की आवश्यकता नहीं है। प्रोजेक्ट के सभी विवरण पहले से लिखित में तय किए जाते हैं, और आपको प्रत्येक कार्य दिवस के अंत में एक लिखित अपडेट प्राप्त होता है।