Standard
US$25.99
或按今天的汇率支付 €23.20 · £19.42——汇率在您将其加入购物车时锁定。
3天内交付
包含版本:0
卖家:Zinn Digital
一款量身定制的 Python 网页爬虫,旨在从任何公共网站自动提取结构化数据,为您节省数小时手动复制粘贴的时间。
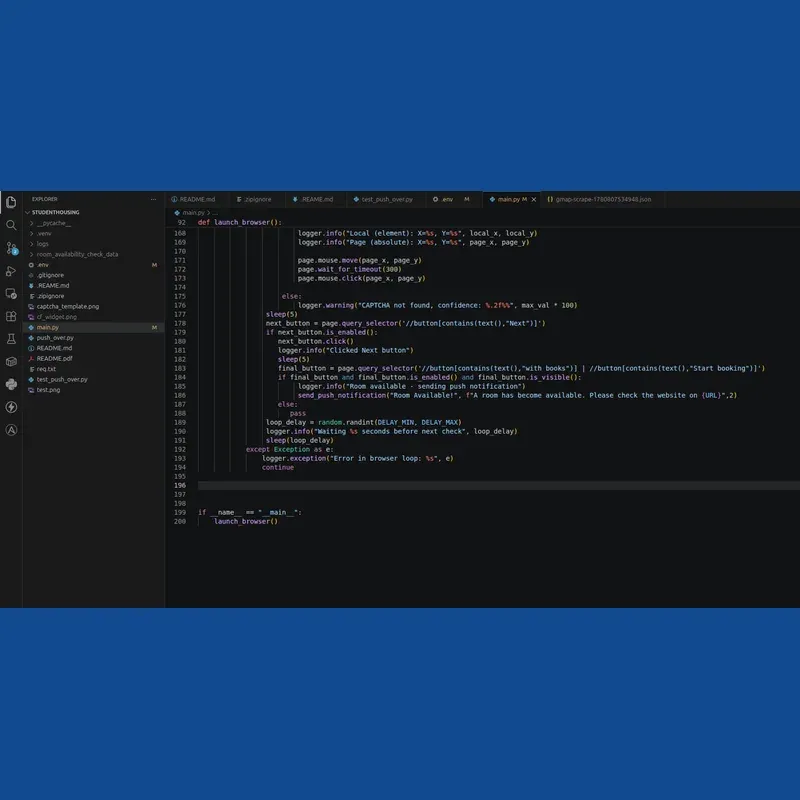
通过人工从网页中收集详细信息既繁琐又容易出错。我们提供量身定制的 Python 脚本,以提取您所需的精确结构化数据,包括定价、联系方式、商品列表和文章等。
我们可以提取的内容
我们使用的工具
处理方式取决于具体网站:BeautifulSoup 和 Requests 适用于静态页面,Selenium 或 Playwright 负责处理动态或重度依赖 JavaScript 的网站,而 Scrapy 则用于更大规模的抓取任务。
运作方式
您需提供订单涉及的域名,并简要说明您需要的数据以及您的使用规划。随后,我们将生成结构清晰且带有详尽注释的脚本,用于处理分页、动态加载、反爬虫障碍和数据格式化,并附带清晰的说明,使您无需技术专长即可运行。
适用对象
本服务面向需要从公开网站进行定期或一次性数据提取的客户,适用于研究、监控、潜在客户挖掘或内容用途,无需自行构建内部爬虫解决方案。
US$25.99
或按今天的汇率支付 €23.20 · £19.42——汇率在您将其加入购物车时锁定。
3天内交付
包含版本:0
无需事先注册账户 — 您的账户将在结账时自动创建。在您验收工作之前,款项由我们代管。