यो सूचीकरणको बारेमा
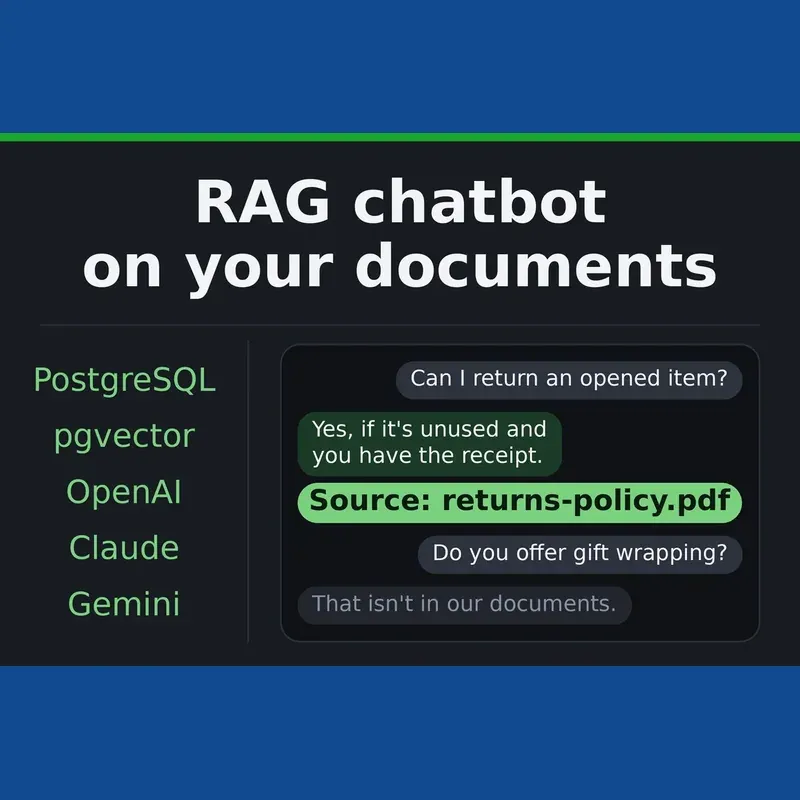
तपाईंका महत्त्वपूर्ण उत्तरहरू तपाईंका म्यानुअलहरू, नीतिहरू, मूल्य सूचीहरू, सहायता लेखहरू र सम्झौताहरूमा पहिल्यै सुरक्षित भइसकेका छन्। हामी यस्तो च्याटबट सिर्जना गर्छौं जसले यी कागजातहरूलाई अध्ययन गर्छ र तिनीहरूभित्र फेला परेका डेटा मात्र प्रयोग गरी जवाफ दिन्छ, साथै प्रत्येक प्रतिक्रियाका लागि सही फाइल र पृष्ठ वा खण्ड सन्दर्भ प्रदान गर्दछ। जब तपाईंका फाइलहरूमा कुनै उत्तर फेला पर्दैन, तब सहायकले अनुमान गर्नुको सट्टा यो कुरा स्पष्ट रूपमा बताउँछ।
प्रत्येक परियोजना तपाईंका आफ्नै २० वटासम्म प्रश्नहरू प्रयोग गरेर प्रमाणीकरण परीक्षणका साथ सम्पन्न हुन्छ। तपाईंले प्रत्येक जवाफ, त्यसको स्रोत र त्यसको शुद्धता मूल्याङ्कन सूचीबद्ध गरिएको विस्तृत स्प्रेडसिट प्राप्त गर्नुहुन्छ, जसपछि एक पटक संशोधन र पूर्ण पुन: परीक्षण गरिन्छ। तपाईंले स्रोत कोडको पूर्ण स्वामित्व कायम राख्नुहुन्छ, र बट तपाईंले रोज्नुभएको AI प्रदायकसँग तपाईंको व्यक्तिगत खातामा चल्ने भएकाले, हाम्रोतर्फबाट कुनै पनि दोहोरिने शुल्क बिना नै सबै उपयोग बिलहरू सीधै तपाईंलाई जान्छन्।
कागजात खोज बटसँग जोडिएको एक कम्प्याक्ट मोडेल मार्फत चल्छ, जबकि अनुक्रमणिका pgvector प्रयोग गरी PostgreSQL मा राखिन्छ। यसले तपाईंका फाइलहरूलाई AI प्रदायकबाट टाढा राख्छ र कुनै पनि Postgres वा Supabase स्थापनामा बाह्य भेक्टर डाटाबेसको आवश्यकतालाई हटाउँछ। भर्खरै गरिएका कामहरूमा निर्वाचन ट्रेडिङ डेस्कको लाइभ Supabase ब्याकइन्डका लागि भेक्टर खोज प्रणाली विकास गर्नु समावेश छ, जसमा फिल्टर गरिएको समानता खोज, टोली-आधारित पहुँच प्रतिबन्धहरू र बचत गर्नु अघि स्वीकृत भाषा मोडेलद्वारा सिर्जित प्रति घण्टाको सारांशहरू समावेश थिए।
सहमति गरिएका विशिष्टताहरू विपरीतका कुनै पनि त्रुटिहरू समाधान गर्नका लागि हामी बिना कुनै अतिरिक्त शुल्क १४ दिनको डेलिभरी पछिको सहायता प्रदान गर्दछौं।
कुनै भिडियो वा फोन कलहरूको आवश्यकता पर्दैन। परियोजनाका सबै विवरणहरू पहिले नै लिखित रूपमा सहमति गरिन्छ, र तपाईंले प्रत्येक कार्य दिनको अन्त्यमा लिखित अपडेट प्राप्त गर्नुहुन्छ।